自研轮臂在 Isaac Sim 中运行
四舵轮双臂进便利店场景,(vx, vy, ω) 控制闭环。这里证明仿真车能开,不是策略已经学会绕行人。
Project 01 · Phase 3
阶段 3 · 强化学习决策(正在进行)
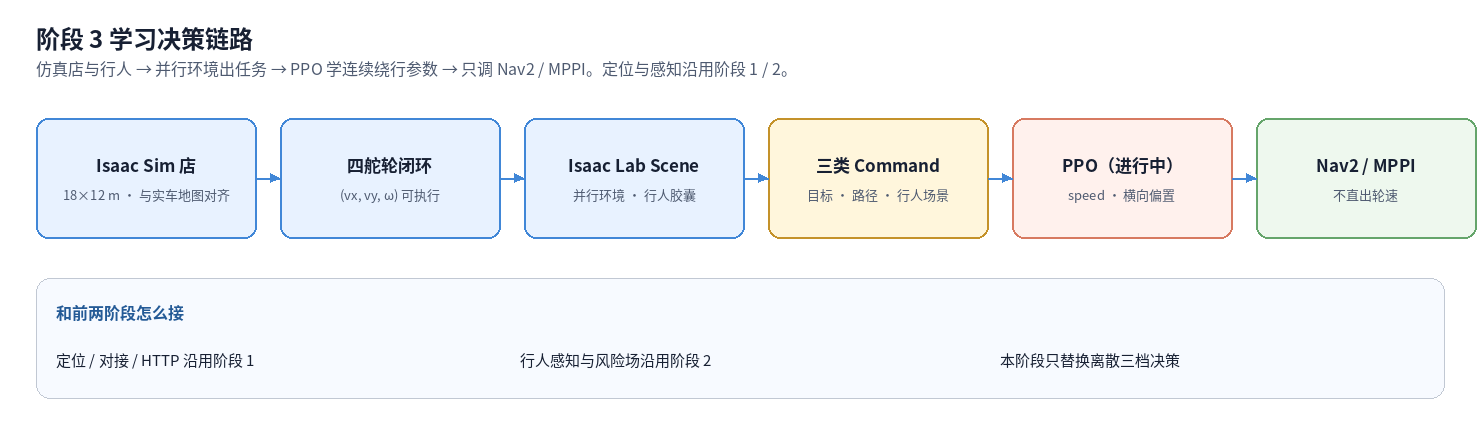
阶段 2 是规则三档。阶段 3 学连续绕行幅度和通过效率,还不直接出底盘速度。
货架 / 收银台 / 通道已对齐
导航目标、参考路径、行人场景
基于 PPO 学习绕行与通过
速度比例 + 横向偏置
四舵轮双臂进便利店场景,(vx, vy, ω) 控制闭环。这里证明仿真车能开,不是策略已经学会绕行人。
01
阶段 2 用风险 × 区域打成正常导航、减速绕行、停车等待。规则稳,但绕多远、什么时候让,都是死档。阶段 3 要在对齐实车地图的仿真里,把绕行幅度和通过效率做成可学习的连续决策。
本人做强化学习决策设计与仿真搭建。定位、对接、HTTP 和行人感知沿用前两阶段。决策由 PPO 强化学习完成。
02
Isaac Sim 里重建便利店,四舵轮吃 (vx, vy, ω)。Isaac Lab 并行出环境和行人;reset 时用三类 Command 出任务。PPO 强化学习出速度比例和横向偏置,去调 Nav2 / MPPI,不直出轮速。
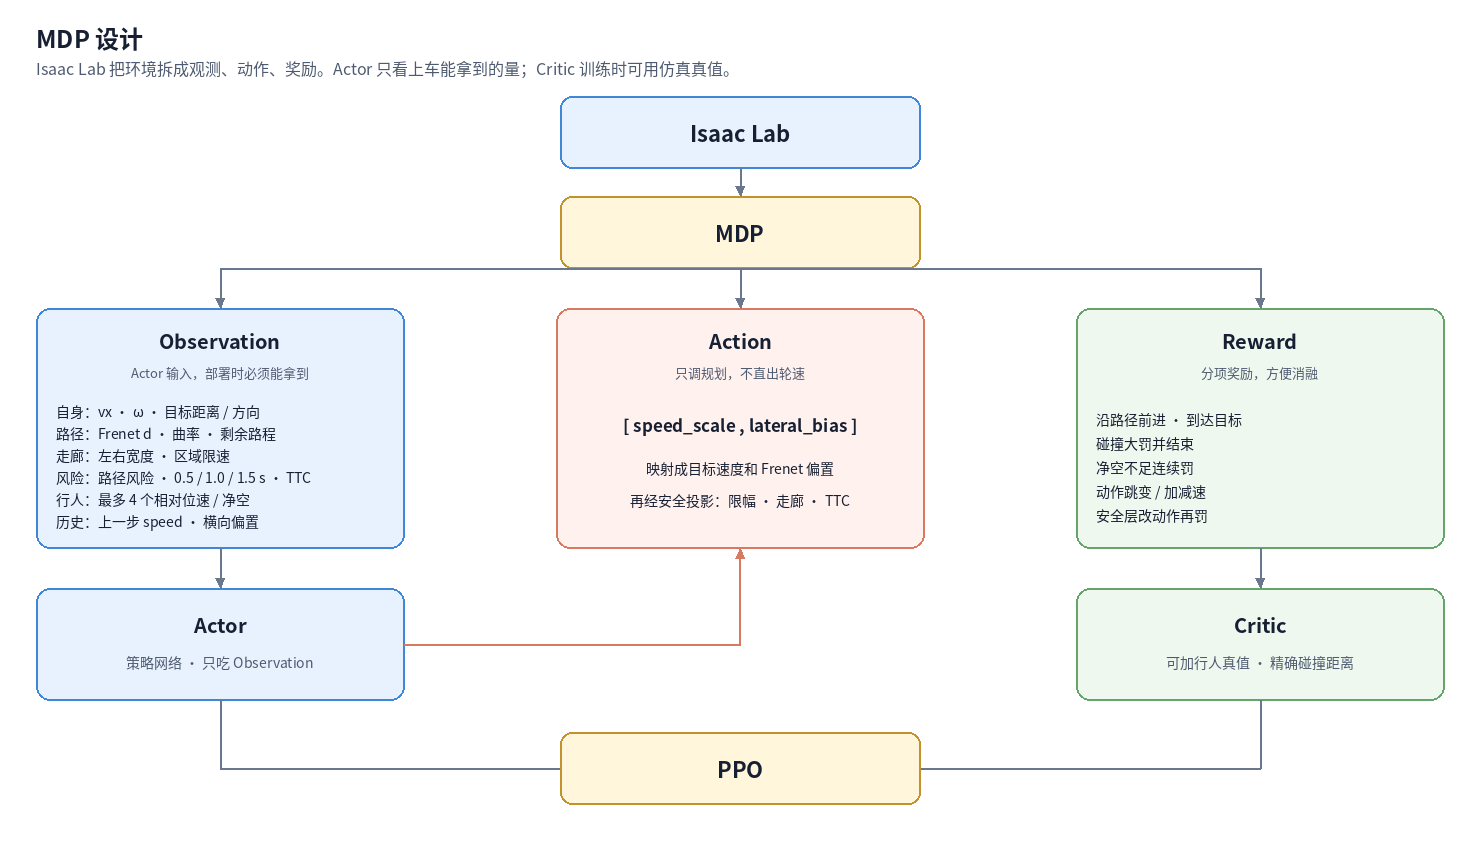
Isaac Lab 把环境拆成观测、动作、奖励。Actor 只看上车能拿到的量:自身、路径、走廊、风险、行人和上一步动作。输出速度比例和横向偏置,经安全投影后调规划。Critic 训练时可用行人真值。PPO 同时更新两端。
03
问题:店的几何和真机地图对不上,训出来的交互过不来。
改动:在 Isaac Sim 6 里用 USD / PhysX 重建 18×12 m 店:货架、墙、收银台、通道和实车 store_layout 用同一套 XY。
效果:仿真走廊和阶段 1 / 2 地图能对上。
问题:没有可控的真机模型,后面的策略接不上实车执行。
改动:导入四舵轮双臂 URDF;控制器做逆解、滞回、舵向限速和对准门控。键盘或 /cmd_vel 都进同一条链,超时清零。
效果:(vx, vy, ω) 能在 Isaac Sim 里稳住开。页头视频就是这条链。
不把决策做成端到端轮速,也不把现有节点原样搬进仿真。Isaac Lab 的 MDP 只把四件事拆开:策略看到什么、能改什么、动作如何变成运动、怎样算好坏。训练逻辑、规划执行和安全约束各管一段。
观测按能否上车切开。Actor 只吃部署时能拿到的量:自身速度、Frenet 路径、走廊宽度、风险与 TTC、最多四个行人,以及上一步动作。Critic 训练时可以看行人真值和精确碰撞距离,这些不上车。
动作是连续的速度比例和横向偏置,映射成目标速度和 Frenet 偏置,再经安全投影做限幅、走廊和 TTC 约束。底层仍走规划跟踪,只改绕多远、过多快,替换阶段 2 的离散三档。
奖励按项记。沿路径的 Frenet 前进和到达给正反馈;碰撞大罚并结束;净空不足连续罚;动作跳变和加减速要罚。安全层改了动作再罚一层,避免策略学会把难决策丢给安全层。
04
强化学习决策设计与仿真搭建:便利店场景、四舵轮控制闭环,以及 Isaac Lab 上的 MDP 与 PPO 决策。
定位、对接、HTTP 和行人感知沿用阶段 1 / 2。本阶段不重写。
本页写阶段 3 的仿真与强化学习决策。